Atténuation des biais de l'IA : guide du cycle de vie pour les praticiens
Découvrez comment atténuer les biais de l'IA tout au long du cycle de vie du modèle et adoptez des approches structurées pour des résultats équitables.
Fundamentals
Kreante11 août 2026le mois dernier
Une atténuation efficace des biais de l'IA commence avant d'écrire la moindre ligne de code : auditez vos données d'entraînement, définissez vos métriques d'équité et mettez en place des points de contrôle de gouvernance avant le déploiement. Les équipes qui traitent le biais comme un problème purement technique obtiennent systématiquement de moins bons résultats que celles qui associent diagnostics statistiques et responsabilité organisationnelle. Le verdict en bref : aucun algorithme ne supprime à lui seul les biais, mais une approche socio-technique structurée sur l'ensemble du cycle de vie du ML vous en rapproche autant que les méthodes actuelles le permettent.
À commencer cette semaine :
Réaliser un audit du jeu de données pour repérer les lacunes de représentation et les valeurs manquantes non aléatoires
Définir au moins deux métriques d'équité pertinentes pour votre cas d'usage et documenter les arbitrages entre elles
Attribuer des responsabilités explicites : un propriétaire du modèle, un intendant des données et un relecteur conformité
Mettre en place un suivi des disparités de résultats avant votre prochaine mise en production
Exécuter un point de contrôle TEVV (test, évaluation, validation, vérification) à chaque étape du cycle de vie
Par où commencer selon la classe de risque : Les systèmes à fort enjeu (recrutement, crédit, triage médical, justice pénale) exigent des correctifs en pré-traitement, des contraintes d'équité pendant l'entraînement, des audits indépendants et une relecture humaine avant tout déploiement. Les systèmes à moindre enjeu peuvent démarrer par une calibration en post-traitement et un suivi, puis remonter vers le pipeline de données à mesure que les preuves de disparité s'accumulent.
Points clés à retenir
Une atténuation efficace des biais de l'IA suppose une approche socio-technique du cycle de vie : les correctifs techniques seuls ne peuvent pas maintenir l'équité sans gouvernance, points de contrôle TEVV et suivi continu.
Point
Détails
Commencer par les données, pas par le modèle
Auditer les données d'entraînement pour repérer les lacunes de représentation et les valeurs manquantes non aléatoires avant tout entraînement.
Attribuer explicitement les rôles de gouvernance
Nommer un propriétaire du modèle, un intendant des données et un relecteur conformité ; sans responsable désigné, les décisions d'équité s'effacent.
Aucune métrique ne suffit à elle seule
L'égalité des chances et la calibration sont mathématiquement incompatibles lorsque les taux de base diffèrent ; documentez l'arbitrage et faites-le valider.
Le post-traitement comporte un risque juridique
Appliquer des seuils propres à un groupe en recrutement ou en crédit peut enfreindre le Title VII ou l'ECOA ; passez toujours par une revue juridique.
Kreante livre une IA auditable
Kreante construit des systèmes d'IA avec documentation TEVV, contraintes d'équité et infrastructure de suivi comme livrables standards.
Que signifie réellement le « biais de l'IA » pour les ingénieurs et les auditeurs ?
Le biais en intelligence artificielle n'est pas un mode de défaillance unique. Pour les praticiens, il est utile de le voir comme une chaîne : les problèmes au niveau du jeu de données se propagent dans le comportement du modèle, qui produit ensuite des préjudices au niveau applicatif. La définition opérationnelle qui compte le plus est celle-ci : un système présente un biais lorsque ses sorties désavantagent ou représentent mal un groupe de manière systématique, sans que l'objectif de la tâche puisse le justifier.
Types de biais qu'il vaut la peine de distinguer :
Biais de représentation / historique : Les données d'entraînement reflètent des discriminations passées (par exemple, un historique de recrutement qui sous-représente les femmes dans les postes techniques), et le modèle apprend donc à reproduire ces schémas.
Biais de sélection / de mesure : Le processus de collecte lui-même fausse l'échantillon, ou les étiquettes mesurent un indicateur indirect plutôt que le résultat réel (par exemple, les casiers d'arrestation comme approximation du comportement criminel).
Biais algorithmique / d'optimisation : La fonction de perte ou le schéma de régularisation optimise la précision globale d'une manière qui sacrifie les performances sur les sous-groupes minoritaires.
Biais de rétroaction / émergent : Les sorties du modèle déployé façonnent les données futures (par exemple, un système de recommandation qui amplifie les contenus déjà populaires, privant de signal les préférences minoritaires).
Deux modes de défaillance illustrent pourquoi cela compte en pratique : un modèle de tri de CV entraîné sur dix ans de décisions de recrutement dans une entreprise tech encodera les schémas de genre et d'établissement d'origine des embauches passées, et attribuera des scores plus faibles aux candidats qui ne correspondent pas à ce profil historique, indépendamment de leurs qualifications réelles. Un modèle de scoring de crédit qui utilise le code postal comme variable servira d'approximation de l'origine ethnique dans les villes historiquement ségréguées, produisant des taux d'acceptation disparates même après le retrait de l'origine ethnique du jeu de variables. Retirer les attributs protégés retire rarement leurs approximations, et c'est pourquoi la seule sélection de variables est un correctif insuffisant.
Comment le cycle de vie de l'IA se traduit-il en atténuation des biais et en gouvernance ?
Le cadre en trois étapes (pré-traitement, pendant l'entraînement, post-traitement) donne aux équipes une structure pratique pour répartir le travail d'atténuation. Chaque étape a ses techniques, son outillage et ses points de contrôle de gouvernance. NIST SP.1270 identifie les jeux de données, le TEVV et les facteurs humains comme les trois grands domaines de difficulté et appelle explicitement à des approches socio-techniques plutôt qu'à des correctifs purement automatisés.
Étape
Ce qui se passe
Principales actions d'atténuation
Outils clés
Point de contrôle TEVV
Pré-traitement
Collecte, étiquetage et curation des données
Échantillonnage stratifié, repondération, documentation du jeu de données
IBM AIF360 (transformations de données), recommandations d'Appen
Revue de validation des données avant l'entraînement
Microsoft Fairlearn, IBM AIF360 (algorithmes appliqués pendant l'entraînement)
Validation du modèle avant la préproduction
Post-traitement
Scoring des sorties et règles de décision
Ajustement des seuils, calibration des scores, égalité des chances
Google What-If Tool, Fairness Indicators
Vérification avant la mise en production
Gouvernance / TEVV
Supervision à toutes les étapes
Pistes d'audit, relecture humaine, validation des parties prenantes
Cadre socio-technique du NIST
Point de contrôle de mise en production, revue d'incident
À quoi sert chaque outil :
IBM AI Fairness 360 (AIF360) : Couvre les trois étapes avec des algorithmes comme Disparate Impact Remover (pré-traitement), Prejudice Remover (pendant l'entraînement) et le post-traitement Equalized Odds. Idéal pour les équipes qui veulent une seule bibliothèque Python couvrant tout le pipeline.
Microsoft Fairlearn : Se concentre sur l'entraînement et le post-traitement, avec un tableau de bord pour comparer les métriques d'équité entre variantes de modèles. Forte intégration avec Azure ML.
Google What-If Tool : Un outil d'inspection visuelle pour l'analyse a posteriori. Il permet de sonder le comportement du modèle par sous-groupe sans écrire de code, utile pour les auditeurs et les chefs de produit.
Fairness Indicators : Une bibliothèque fondée sur TensorFlow pour calculer et visualiser à grande échelle les métriques d'équité de groupe, généralement utilisée aux étapes de post-traitement et de suivi.
Une revue Frontiers de 2025 propose de coupler des diagnostics statistiques formels avec des mécanismes de gouvernance tout au long du cycle de vie, en reliant directement les atténuations techniques aux obligations réglementaires. Ce cadrage est plus utile que de traiter chaque étape comme un correctif isolé.
Quelles étapes de pré-traitement réduisent les biais avant le début de l'entraînement ?
C'est au pré-traitement que l'on obtient le plus d'effet de levier pour le moindre coût en complexité de modèle. Corriger les données avant l'entraînement évite d'avoir à compenser ensuite par des objectifs sous contrainte ou des rustines a posteriori.
Collecte des données et représentativité :
Utilisez un échantillonnage stratifié pour garantir une représentation minimale de chaque groupe protégé, et pas seulement des objectifs de taille d'échantillon globale.
Appliquez un suréchantillonnage ciblé aux sous-groupes sous-représentés lorsque la stratification seule ne comble pas l'écart, mais documentez-en la justification ainsi que le risque que les exemples minoritaires synthétiques ne reflètent pas la variation réelle.
Auditez la distribution des variables par sous-groupe avant l'entraînement : cherchez les différences systématiques de valeurs manquantes, d'erreur de mesure ou de bruit d'étiquetage selon le groupe.
Qualité de l'annotation :
Recrutez des annotateurs présentant une diversité démographique pertinente pour le domaine de la tâche. Une tâche d'étiquetage de sentiment sur des données de service client a besoin d'annotateurs qui reflètent la base clients, pas seulement du vivier par défaut du prestataire d'annotation.
Utilisez des protocoles d'arbitrage des étiquettes (vote majoritaire, Dawid-Skene ou recueil structuré des désaccords) plutôt que d'écarter les exemples ambigus. Le désaccord est lui-même un signal : il marque souvent les cas où le biais est le plus susceptible d'apparaître.
Consignez les métadonnées des annotateurs (profil, version des consignes, taux de désaccord) dans la fiche du jeu de données, afin que les auditeurs en aval puissent évaluer la qualité de l'étiquetage.
Augmentation synthétique :
Les données synthétiques peuvent aider lorsque les données réelles d'un sous-groupe sont réellement rares, mais elles reproduisent les biais du modèle génératif qui les a produites. Validez toujours les échantillons synthétiques face à des données réelles mises de côté pour le sous-groupe visé avant de les intégrer à l'entraînement.
Checklist de documentation du jeu de données :
Fiche du jeu de données avec la méthodologie de collecte, la période couverte et les lacunes connues
Champs de provenance : source, agent collecteur, statut du consentement
Statistiques de distribution par sous-groupe pour tous les attributs protégés pertinents pour le cas d'usage
Version du schéma d'étiquetage et protocole d'arbitrage
Limites connues et avertissements hors distribution
Les recommandations pratiques d'Appen sur les données d'entraînement mettent en avant l'échantillonnage structuré et la diversité des annotateurs parmi les interventions précoces les plus efficaces dont disposent les équipes avant tout entraînement.
Astuce :Les valeurs manquantes non aléatoires sont l'une des sources de biais les moins souvent diagnostiquées. Si les données manquent plus souvent pour un sous-groupe (par exemple, des patients minoritaires ayant moins de consultations), imputer par la moyenne de la population sous-estimera systématiquement les vraies valeurs de ce groupe. Testez les schémas de valeurs manquantes par groupe avant toute étape d'imputation.
Quelles méthodes appliquées pendant l'entraînement améliorent l'équité du machine learning ?
Les techniques appliquées pendant l'entraînement modifient l'objectif lui-même, ce qui leur donne plus de portée structurelle que les correctifs a posteriori, mais introduit aussi des arbitrages de précision qui doivent être documentés explicitement.
Objectifs tenant compte de l'équité :
La parité démographique impose des taux de prédiction positive égaux entre les groupes. Cette contrainte convient lorsque les taux de base du résultat sont réellement égaux d'un groupe à l'autre, ce qui est rarement le cas.
L'égalité des chances impose des taux de vrais positifs et de faux positifs égaux entre les groupes. Cette contrainte convient mieux à la classification à fort enjeu, où les deux types d'erreur ont des coûts asymétriques.
L'équité individuelle exige que des individus similaires reçoivent des prédictions similaires. Ces objectifs sont plus difficiles à rendre opérationnels, car la « similarité » doit être définie dans un espace métrique propre à la tâche.
Repondération et rééchantillonnage :
Attribuer des poids de perte plus élevés aux sous-groupes sous-représentés ou historiquement défavorisés pendant l'entraînement est peu coûteux en calcul et souvent efficace en première approche. Microsoft Fairlearn propose plusieurs approches de repondération aux côtés de ses méthodes sous contrainte. La limite : la repondération aide sur la représentation, mais ne traite pas les variables indirectes qui encodent l'appartenance à un groupe.
Débiaisage adversarial :
Entraînez un modèle principal aux côtés d'un adversaire qui tente de prédire l'attribut protégé à partir des représentations du modèle principal. Le modèle principal est pénalisé lorsque l'adversaire réussit. IBM AIF360 inclut une implémentation du débiaisage adversarial. Cette approche est plus gourmande en calcul et exige un réglage soigneux du taux d'apprentissage de l'adversaire par rapport à celui du modèle principal.
Régularisation :
Ajouter un terme de pénalité d'équité à la fonction de perte (par exemple, en pénalisant l'écart de taux de faux positifs entre groupes) est une approche souple qui s'intègre à la plupart des pipelines d'entraînement standards. Le poids de la pénalité est un hyperparamètre qui contrôle directement l'arbitrage entre précision et équité.
Comment choisir une stratégie :
Jeu de données réduit, risque réglementaire élevé : commencez par la repondération (peu coûteuse, interprétable), puis validez avec les méthodes sous contrainte de Fairlearn.
Grand jeu de données, risque modéré : le débiaisage adversarial ou la régularisation offre davantage de garanties structurelles, mais demande plus de calcul et de réglage.
Budget de calcul serré : la repondération et le rééchantillonnage n'ajoutent presque aucun surcoût ; le débiaisage adversarial double à peu près le temps d'entraînement.
Équité individuelle exigée par contrat ou par la réglementation : définissez la métrique de similarité avec le service juridique avant l'entraînement, car ce choix est en lui-même une décision normative.
L'arbitrage entre précision et équité est réel et ne peut pas être totalement supprimé par l'ingénierie. Documentez la frontière de Pareto entre votre métrique de précision principale et chaque métrique d'équité, et faites valider explicitement par le juridique et les responsables produit le point de fonctionnement acceptable.
Quand recourir aux correctifs de post-traitement, et quels sont les risques juridiques ?
Les ajustements de post-traitement modifient les sorties du modèle après l'entraînement, ce qui les rend rapides à déployer et faciles à itérer. C'est le bon point de départ pour les prototypes, pour les systèmes où le réentraînement coûte cher, et pour les situations où un problème d'équité est détecté en production et exige une réponse immédiate.
Techniques principales :
Calibration des scores : Ajuste les probabilités produites par le modèle pour que les probabilités prédites correspondent aux taux de résultats observés dans chaque groupe. La calibration ne change pas l'ordre de classement, mais corrige les excès ou défauts systématiques de confiance selon le groupe.
Ajustement des seuils : Fixe des seuils de décision différents selon les groupes afin d'égaliser une métrique choisie (par exemple, des taux de faux positifs égaux). C'est le correctif de post-traitement le plus courant et le plus sensible juridiquement.
Post-traitement par égalité des chances : Une méthode formelle (disponible dans AIF360) qui détermine les seuils optimaux par groupe pour satisfaire les contraintes d'égalité des chances, compte tenu des distributions de scores du modèle.
Quand le post-traitement est approprié :
Phase de prototype ou de MVP, lorsque le réentraînement n'est pas encore envisageable
Systèmes à faible enjeu où la disparité est modeste et le correctif bien documenté
Situations où l'architecture du modèle est figée (système tiers ou hérité)
Quand c'est risqué :
L'analyse de Tepper Perspectives (CMU) est directe sur ce point : le post-traitement peut être efficace en calcul, mais soulève des problèmes juridiques et éthiques dans les domaines réglementés, car il implique un usage explicite de l'appartenance à un groupe sensible pour modifier les sorties. En recrutement et en crédit, appliquer des seuils différents selon l'origine ethnique ou le genre peut enfreindre le Title VII ou l'Equal Credit Opportunity Act, selon la mise en œuvre et selon qu'elle peut être défendue comme une nécessité opérationnelle. L'exposition juridique n'a rien d'hypothétique.
Exigences de documentation en cas de post-traitement :
Consigner la métrique d'équité visée et la raison de ce choix
Documenter la justification juridique (par exemple, analyse d'impact défavorable, défense de nécessité opérationnelle)
Journaliser les valeurs de seuil, la date de leur fixation et la personne qui les a approuvées
Suivre l'impact de l'ajustement sur la précision pour chaque groupe
N'appliquez jamais de seuils par groupe dans un domaine réglementé sans revue juridique. Le correctif technique peut être simple ; l'exposition juridique ne l'est pas.
Comment mesurer l'équité et mener un processus TEVV ?
La mesure est le poste sur lequel la plupart des équipes investissent trop peu. Choisir une seule métrique d'équité et la publier sans contexte, c'est ainsi que des organisations finissent par revendiquer l'équité alors qu'une autre métrique montre une disparité nette.
Principales métriques d'équité et cas d'usage :
Métrique
Ce qu'elle détecte
Accès aux données requis
Limite principale
Différence de parité statistique
Écart des taux de prédiction positive entre groupes
Sorties du modèle uniquement
Ignore les écarts de taux de base ; peut pénaliser des modèles justes
Égalité des chances (parité TPR/FPR)
Taux d'erreur différenciés selon le groupe
Sorties + étiquettes de vérité terrain
Exige une vérité terrain étiquetée ; peut entrer en conflit avec la calibration
Calibration par groupe
Si les probabilités prédites correspondent aux taux réels par groupe
Probabilités prédites + résultats
Ne capture pas les disparités d'ordre de classement
Équité contrefactuelle
Si modifier uniquement l'attribut protégé change la prédiction
Accès interne au modèle ou à des données contrefactuelles
Difficile à opérationnaliser ; exige un modèle causal
Score d'équité individuelle
Si des individus similaires obtiennent des prédictions similaires
Définition d'une métrique de similarité + sorties du modèle
La métrique de similarité est normative, pas objective
Une étude arXiv de 2023 sur l'évaluation des biais des LLM formule un point qui vaut au-delà des modèles de langage : la bonne métrique dépend de l'accès dont vous disposez au modèle. Si vous n'avez que du texte généré, vous ne pouvez pas calculer de métriques fondées sur les probabilités. Si vous avez les plongements, les diagnostics au niveau des représentations deviennent possibles. Alignez le choix de vos métriques sur votre accès réel au modèle avant d'arrêter un plan de mesure.
Checklist de tests TEVV :
Tests unitaires : vérifier le calcul des métriques d'équité sur des données synthétiques dont la vérité terrain est connue
Tests par tranche : calculer toutes les métriques principales ventilées par attribut protégé et par leurs intersections
Tests adversariaux : sonder le modèle avec des entrées modifiées a minima qui ne changent que l'attribut protégé (sondage contrefactuel)
Tests de résistance au biais : tester sur des données de sous-groupes hors distribution pour détecter la fragilité
Tests de régression : confirmer qu'un correctif d'équité sur un groupe n'a pas dégradé les métriques d'un autre groupe
NIST SP.1270 précise explicitement que le TEVV complète, mais ne remplace pas, une démarche de conception scientifique. Dérouler une checklist TEVV sur un système mal conçu produit un système mal conçu et bien testé.
Astuce :Choisissez une métrique d'équité principale et une métrique secondaire avant le début de l'entraînement, et documentez l'arbitrage que vous acceptez entre les deux. L'égalité des chances et la calibration sont mathématiquement incompatibles lorsque les taux de base diffèrent d'un groupe à l'autre (c'est un résultat d'impossibilité démontré, pas une limite d'outillage). Décider laquelle privilégier est une décision de politique, pas une décision technique, et elle doit être validée par la direction juridique et produit.
Quelles structures de gouvernance ancrent durablement l'atténuation des biais ?
Les correctifs techniques sans gouvernance finissent par s'effacer. Le cadre intégré publié dans Frontiers est explicite : c'est le couplage de diagnostics statistiques formels avec des mécanismes de gouvernance qui soutient réellement la réduction des biais sur tout le cycle de vie de l'IA. Le cadrage socio-technique du NIST va dans le même sens : la gouvernance, la relecture humaine et la conception participative ne sont pas des options ajoutées au travail d'ingénierie.
Checklist de gouvernance :
Désigner nommément un propriétaire du modèle responsable des résultats d'équité (et pas seulement des performances)
Désigner un intendant des données chargé de la documentation et de la provenance du jeu de données
Exiger la validation d'un auditeur indépendant pour les systèmes à fort enjeu avant la mise en production
Documenter toutes les décisions d'équité (choix de métriques, valeurs de seuil, justification des arbitrages) dans une fiche de modèle
Instaurer un point de contrôle de mise en production : les résultats TEVV doivent atteindre les seuils convenus avant toute autorisation de déploiement
Conception participative et implication des parties prenantes :
Impliquez des représentants des communautés concernées dès le cadrage du problème, et pas seulement lors des tests a posteriori. Un outil de recrutement conçu sans l'avis des populations de candidats qu'il affecte passera à côté de modes de défaillance invisibles pour les équipes internes.
Organisez des sessions de retour structurées avec les utilisateurs de terrain (recruteurs, chargés de crédit, cliniciens) qui manipulent les sorties du modèle au quotidien. Ils repèrent souvent les schémas de disparité avant les métriques.
Documentez les retours des parties prenantes dans la fiche de modèle, aux côtés des spécifications techniques.
Modèles de supervision humaine :
La relecture humaine doit primer sur les sorties du modèle lorsque : la confiance du modèle est inférieure à un seuil défini, la décision affecte une catégorie protégée dans un domaine réglementé, ou le résultat est irréversible (licenciement, refus de crédit, triage médical). Pour l'implémentation de l'IA en entreprise, la conception de cette supervision humaine fait souvent la différence entre un système défendable et un risque.
Traduire les résultats TEVV en actions de gouvernance :
Mise en production : toutes les métriques d'équité principales atteignent les seuils convenus, la fiche de modèle est complète, la validation juridique est obtenue
Restriction : une ou plusieurs métriques secondaires montrent une disparité ; déployer avec relecture humaine obligatoire sur les cas signalés
Blocage : la métrique d'équité principale n'atteint pas le seuil, ou la revue juridique identifie un risque inacceptable ; retour à l'étape de pré-traitement ou d'entraînement
Comment surveiller les biais après le déploiement ?
Le déploiement n'est pas la ligne d'arrivée. Le biais peut apparaître ou réapparaître à mesure que la distribution des données réelles s'écarte de celle de l'entraînement, que les comportements des utilisateurs changent, ou que les sorties du système alimentent les données sur lesquelles il sera réentraîné.
Checklist de suivi :
Suivre la dérive des données : surveiller chaque semaine la distribution des variables d'entrée et alerter dès qu'une distribution s'écarte au-delà d'un seuil défini (par exemple, l'écart-type de la population)
Suivre la dérive des étiquettes : si la vérité terrain est disponible avec un décalage, surveiller dans le temps les taux d'étiquettes par sous-groupe
Suivre la dérive des disparités de résultats : calculer vos métriques d'équité principales sur des fenêtres glissantes de production (par exemple, 30 jours glissants) et alerter lorsqu'elles franchissent le seuil convenu
Effectuer des contrôles de distribution : comparer chaque mois la population en production à la population d'entraînement sur les attributs protégés
Canaux de retour utilisateur :
Une étude Nature de 2025 recommande des boucles de retour utilisateur continues comme composant critique de la détection des biais sur le long terme. En pratique, la plupart des déploiements en entreprise l'omettent totalement. Une implémentation minimale : un bouton « signaler ce résultat » sur les décisions assistées par le modèle, dirigé vers une file de tri examinée chaque semaine par l'intendant des données. Les implémentations plus abouties utilisent des formulaires structurés qui recueillent la description de la disparité par l'utilisateur, le groupe concerné et le contexte de la décision.
Étapes de réponse à incident :
Atténuation immédiate : si un incident de biais est confirmé, appliquer le correctif le plus rapide disponible (ajustement de seuil, orientation vers une relecture humaine, ou retour à la version précédente du modèle)
Critères de retour arrière : définissez-les avant le déploiement, pas pendant l'incident. Une hausse de 10 % de l'écart de taux de faux positifs par rapport à la référence est un déclencheur raisonnable pour la plupart des systèmes à fort enjeu
TEVV de cause racine : dérouler toute la checklist TEVV sur les données de l'incident pour déterminer si la défaillance vient d'une dérive des données, d'une dérive des étiquettes ou d'une fragilité du modèle
Communication : prévenir les parties prenantes concernées dans un délai défini (24 heures pour les systèmes à fort enjeu) ; documenter l'incident, sa cause racine et la remédiation dans la fiche de modèle
Mesurer l'efficacité de la remédiation consiste à recalculer vos métriques d'équité principales sur la fenêtre de production postérieure au correctif et à les comparer à la fois à la référence d'avant l'incident et aux résultats TEVV d'avant le déploiement. Un correctif qui ramène la métrique à son niveau de référence ne traite pas nécessairement la cause racine.
Vous pouvez aussi utiliser des outils comme un test de visibilité dans les moteurs de recherche IA pour suivre la façon dont vos contenus produits par l'IA sont remontés et classés selon les plateformes, ce qui peut révéler des disparités visibles par les utilisateurs que les métriques internes manquent.
À quoi ressemble un plan de mise en œuvre réaliste ?
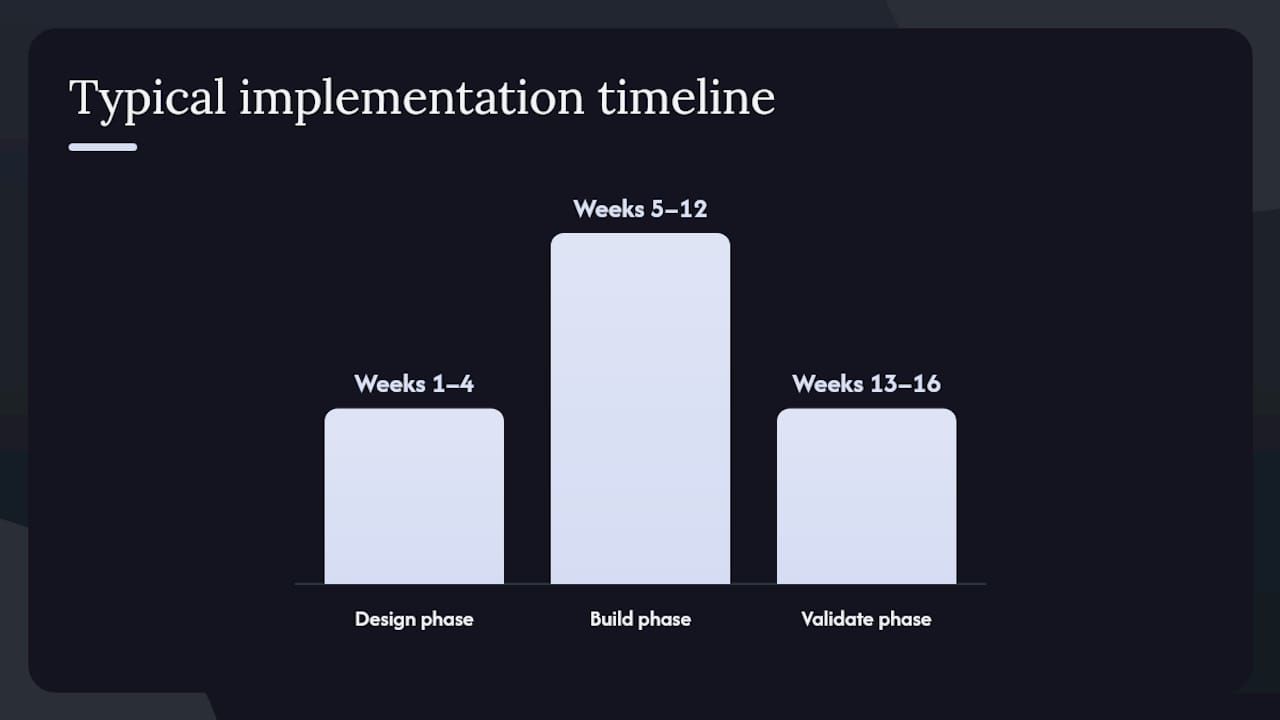
Un programme d'atténuation des biais est un effort d'ingénierie et de gouvernance mené par phases, pas un audit ponctuel. Le calendrier ci-dessous reflète les durées typiques pour une équipe de taille intermédiaire qui construit ou met à niveau un système ML en production.
Phase de conception (semaines 1–4) : Définir le périmètre du cas d'usage, identifier les attributs protégés pertinents pour la tâche, choisir les métriques d'équité principale et secondaire, rédiger le modèle de fiche et attribuer les rôles de gouvernance. Point de décision : validation par les parties prenantes du choix des métriques et des arbitrages acceptables avant tout travail sur les données.
Phase de construction (semaines 5–12) : Réaliser l'audit du jeu de données, appliquer les correctifs de pré-traitement, entraîner avec des objectifs tenant compte de l'équité ou une repondération, et exécuter les premiers tests TEVV par tranche. Point de décision : résultats TEVV examinés par le propriétaire du modèle et l'intendant des données avant la préproduction.
Phase de validation (semaines 13–16) : Audit indépendant des résultats TEVV (interne ou externe), revue juridique des décisions de post-traitement le cas échéant, et examen de la fiche de modèle par les parties prenantes. Point de décision : validation juridique et conformité avant la mise en production.
Phase de déploiement (semaine 17 et suivantes) : Mise en production avec l'infrastructure de suivi active dès le premier jour. Fixer les seuils d'alerte, activer les canaux de retour utilisateur et planifier la première revue de production à 30 jours.
Phase de suivi (en continu) : Revue mensuelle des métriques d'équité, mise à jour trimestrielle de la fiche de modèle, audit indépendant annuel pour les systèmes à fort enjeu.
Matrice des rôles :
Responsable produit : définit les arbitrages d'équité acceptables, pilote la communication avec les parties prenantes
Ingénieur données : réalise l'audit du jeu de données, met en œuvre les correctifs de pré-traitement, tient à jour les enregistrements de provenance
Ingénieur ML : met en œuvre les contraintes pendant l'entraînement, exécute le TEVV, maintient les pipelines de suivi
Responsable annotation : recrute des annotateurs divers, fait appliquer les protocoles d'arbitrage, documente les métadonnées d'étiquetage
Juridique / conformité : examine les décisions de post-traitement, approuve la fiche de modèle pour les domaines réglementés
Auditeur externe : revue TEVV indépendante pour les systèmes à fort enjeu ; généralement mobilisé en phase de validation
Postes de coût : La collecte et l'annotation des données sont généralement le premier poste de dépense pour les équipes qui partent de zéro. Les audits indépendants des systèmes à fort enjeu (recrutement, crédit, santé) vont de quelques dizaines de milliers à plus de 100 000 $ selon le périmètre. Le coût de calcul du débiaisage adversarial représente environ le double d'un entraînement standard. Pour un MVP, réduisez le périmètre en commençant par la calibration de post-traitement et le suivi, puis investissez dans les correctifs de pré-traitement et d'entraînement à mesure que les preuves de disparité s'accumulent.
Au moment de choisir une agence de développement IA, vérifiez que le prestataire peut présenter une documentation TEVV et qu'il a l'expérience de l'entraînement sous contrainte d'équité, et pas seulement de la livraison de modèles standards.
Astuce :Pour un audit indépendant à budget serré, un exercice de red team structuré avec des praticiens ML externes coûte bien moins cher qu'un audit formel par un tiers et détecte la plupart des mêmes modes de défaillance. Documentez la méthodologie et les conclusions du red team dans la fiche de modèle pour démontrer votre diligence.
Quels outils et bibliothèques utiliser pour détecter les biais ?
L'écosystème est assez mature pour que la plupart des équipes démarrent sans développer d'outillage sur mesure. Le choix de la bibliothèque dépend de l'étape du cycle de vie où vous vous trouvez et de l'accès dont vous disposez au modèle.
IBM AI Fairness 360 (AIF360) : La couverture la plus large de toutes les bibliothèques open source, avec des algorithmes de pré-traitement, d'entraînement et de post-traitement dans un seul paquet Python. On y trouve Disparate Impact Remover, Reweighing (pré-traitement), Prejudice Remover et Adversarial Debiasing (pendant l'entraînement), ainsi que le post-traitement Equalized Odds. Idéal pour les équipes qui veulent une seule dépendance et sont à l'aise avec Python. L'effort d'intégration est modéré ; l'API est cohérente, mais la documentation suppose une familiarité avec les concepts d'équité.
Microsoft Fairlearn : Le plus solide pendant l'entraînement et en post-traitement, avec une API sous contrainte claire et un tableau de bord interactif pour comparer les métriques d'équité entre variantes de modèles. S'intègre nativement à scikit-learn et à Azure ML. Effort d'intégration moindre qu'AIF360 pour les équipes déjà sur la pile Microsoft.
Google What-If Tool : Un outil visuel dans le navigateur pour l'analyse a posteriori des modèles. Aucun code n'est nécessaire pour un usage de base, ce qui le rend accessible aux auditeurs et aux chefs de produit qui ne sont pas ingénieurs ML. À privilégier pour l'analyse exploratoire et les démonstrations aux parties prenantes plutôt que pour des pipelines de tests automatisés.
Fairness Indicators : Un composant TensorFlow Extended (TFX) pour calculer à grande échelle les métriques d'équité de groupe. Conçu pour les pipelines de production plutôt que pour l'analyse ponctuelle. Idéal pour les équipes sous TFX ou TensorFlow Serving qui ont besoin d'intégrer les métriques d'équité à leur pipeline CI/CD.
Jeux de données et références : Pour l'évaluation en NLP et sur les LLM, les jeux de données WinoBias et WinoGender testent le biais de genre dans la coréférence ; StereoSet et CrowS-Pairs testent les associations stéréotypées. Pour les données tabulaires, Adult Income, COMPAS recidivism et German Credit sont les références standards, même si toutes portent leurs propres biais historiques et ne doivent pas être prises pour une vérité terrain dans des décisions de déploiement réelles.
Open source ou commercial : Les outils open source (AIF360, Fairlearn, What-If Tool) couvrent la plupart des cas d'usage et sont gratuits. Les plateformes commerciales y ajoutent des pistes d'audit, une gestion des accès par rôle et des rapports de conformité que les secteurs réglementés exigent souvent. L'étude arXiv sur les biais des LLM note que, pour les modèles de langage en particulier, le choix des métriques dépend fortement de l'accès au modèle : si vous n'avez qu'un accès API au texte généré, les diagnostics au niveau des plongements sont indisponibles, ce qui restreint nettement votre boîte à outils.
Quelles sont les vraies limites de l'atténuation des biais et comment les expliquer ?
Le « biais zéro » n'est pas un objectif atteignable. Ce n'est pas une limite d'outillage, mais une limite mathématique. Le résultat d'impossibilité le plus cité en équité du machine learning montre que la calibration, l'égalité des taux de faux positifs et l'égalité des taux de faux négatifs ne peuvent pas être satisfaites toutes les trois en même temps lorsque les taux de base diffèrent entre groupes. Chaque métrique d'équité que vous optimisez revient implicitement à accepter de moins bonnes performances sur une autre.
Arbitrages d'impossibilité les plus courants :
Satisfaire la parité démographique dans un modèle de recrutement produira des taux de faux positifs différents entre des groupes dont les taux de base de qualification diffèrent
Satisfaire l'égalité des chances suppose d'accepter une calibration imparfaite selon le groupe
L'équité individuelle et les métriques d'équité de groupe entrent souvent en conflit lorsque la métrique de similarité et la frontière de groupe ne coïncident pas
Une revue scientifique publiée sur PMC soutient que de nombreux biais restent inconnus et que le biais résiduel pose de véritables défis éthiques. Conséquence pratique : les équipes doivent communiquer l'incertitude, adopter des pratiques de communication informées par l'éthique et résister à la tentation d'affirmer qu'un système est « équitable » parce qu'une seule métrique franchit un seuil.
Modèles de communication pour les parties prenantes :
Pour le juridique et la conformité : « Ce système atteint [métrique] au niveau [seuil] à la date du [date]. Il ne satisfait pas simultanément [métrique en conflit], ce qui constitue une contrainte mathématique documentée dans la fiche de modèle. L'arbitrage a été approuvé par [nom] le [date]. »
Pour le produit et la direction : « Nous avons réduit la disparité de [résultat] entre [groupe A] et [groupe B] de [X] à [Y]. Une disparité résiduelle subsiste et fait l'objet d'un suivi mensuel. Une réduction supplémentaire exigerait [investissement ou changement de conception]. »
Pour la communication publique : « Ce système utilise une aide à la décision automatisée. Les décisions concernant [résultat] sont examinées par une personne avant toute action définitive. Les limites connues sont documentées sur [lien]. »
Risques en aval à signaler explicitement :
Perte de compétence : les relecteurs humains qui s'appuient fortement sur les sorties du modèle perdent avec le temps la capacité de juger par eux-mêmes. Le phénomène est particulièrement aigu dans les contextes médicaux et juridiques.
Complaisance envers l'automatisation : les relecteurs valident les recommandations du modèle à un taux plus élevé que leurs propres évaluations indépendantes, même lorsque le modèle se trompe. Concevez les interfaces de relecture pour présenter les sorties du modèle après que le relecteur s'est forgé un premier jugement.
Astuce :Lorsque vous présentez les limites d'équité à des dirigeants, commencez par le risque business qu'il y a à en promettre trop, pas par la complexité technique. Affirmer publiquement qu'un système est « non biaisé » et se voir contredire ensuite par un audit externe crée une exposition juridique et réputationnelle sans commune mesure avec le coût d'une communication exacte et nuancée dès le départ.
Comment atténuer les biais en apprentissage non supervisé et par renforcement ?
La classification supervisée occupe l'essentiel de la littérature sur l'atténuation des biais, mais les systèmes non supervisés et par renforcement ont leurs propres modes de défaillance.
Apprentissage non supervisé : Les modèles de clustering et de plongement n'ont pas d'étiquettes explicites, ce qui change la façon dont le biais se manifeste. Les plongements de mots entraînés sur de grands corpus encodent des stéréotypes professionnels et de genre dans leur structure géométrique (l'exemple classique : « l'homme est au médecin ce que la femme est à l'infirmière » en arithmétique vectorielle). Les méthodes de réduction de dimension comme l'ACP ou UMAP peuvent comprimer une variance disproportionnellement importante pour les sous-groupes minoritaires, produisant des représentations où ces groupes se regroupent mal ou sont confondus avec les groupes majoritaires.
Les approches d'atténuation en non supervisé consistent notamment à : auditer les espaces de plongement à la recherche d'associations stéréotypées avec des outils comme le Word Embedding Association Test (WEAT) ; appliquer un débiaisage a posteriori aux espaces de plongement (par exemple, la méthode de hard-debiasing de Bolukbasi et al., dont l'efficacité reste débattue) ; et évaluer les métriques de qualité de clustering ventilées par sous-groupe pour détecter une représentation différenciée.
Apprentissage par renforcement : Les systèmes d'apprentissage par renforcement apprennent à partir de signaux de récompense, si bien que le biais entre par la conception de la fonction de récompense et par la dynamique de l'environnement. Un système de recommandation optimisé pour l'engagement amplifiera les contenus qui suscitent de fortes réactions, ce qui tend à favoriser les préférences majoritaires et peut systématiquement mal servir les utilisateurs minoritaires. Un agent de recrutement optimisé pour le « recrutement réussi » (défini par la rétention) encodera tous les biais présents dans les données historiques de rétention.
L'atténuation en apprentissage par renforcement suppose : d'auditer la fonction de récompense à la recherche d'objectifs indirects corrélés aux attributs protégés ; de tester la politique apprise sur des états d'environnement stratifiés par sous-groupe ; et d'appliquer des contraintes d'équité à l'optimisation de la politique (l'équivalent des contraintes appliquées pendant l'entraînement supervisé, mais portées sur le gradient de politique). La supervision humaine y est particulièrement importante, car la boucle entre les sorties du modèle et les futures données d'entraînement est plus courte et plus rapide que dans un cadre supervisé statique.
L'écart entre l'équité sur le papier et l'équité en pratique
Le schéma d'échec le plus constant en atténuation des biais n'est pas un mauvais algorithme. C'est un manque de gouvernance : les équipes exécutent le TEVV, produisent une fiche de modèle, puis déploient sans l'infrastructure de suivi qui permettrait de détecter que la population réelle diverge de la population de test.
Le deuxième échec le plus fréquent est le théâtre métrique : choisir une métrique d'équité que le modèle satisfait déjà (ou peut satisfaire avec un ajustement minime) plutôt que celle qui capture réellement le préjudice que le système pourrait causer. La parité démographique est facile à atteindre dans bien des contextes ; l'égalité des chances sur un résultat à fort enjeu l'est beaucoup moins. Le choix de la métrique est une décision de politique, et lorsqu'il est fait par l'équipe ML sans le juridique ni le produit, il tend à optimiser ce qui est techniquement commode plutôt que ce qui est éthiquement défendable.
La conception participative est l'intervention qui change le plus systématiquement cette dynamique. Lorsque les communautés concernées participent à définir ce que « équitable » veut dire pour un cas d'usage précis, le choix des métriques devient une négociation aux enjeux réels plutôt qu'un exercice technique. Cette négociation est inconfortable, mais elle fait remonter les arbitrages qui resteraient sinon cachés jusqu'à ce qu'un audit externe ou un échec public les rende visibles.
Une observation pratique qu'il vaut la peine d'énoncer clairement : les équipes qui réussissent traitent l'atténuation des biais comme une exigence produit, avec un responsable, un budget et une feuille de route, pas comme une case à cocher de conformité. L'écart de résultats entre ces deux cadrages est considérable.
Kreante construit des systèmes d'IA équitables qui tiennent face à un audit
Déployer une fonctionnalité d'IA qui obtient de bons résultats sur des métriques agrégées mais échoue à un audit d'équité six mois plus tard coûte cher. Les services de développement de solutions d'IA de Kreante sont conçus autour de résultats mesurables dès le départ : des points de contrôle TEVV intégrés au calendrier de livraison, des fiches de modèle produites comme livrables (et non après coup), et une infrastructure de suivi livrée avec le modèle.
Pour les équipes qui doivent avancer vite sans faire l'impasse sur la gouvernance, Kreante livre des prototypes fonctionnels dont les contraintes d'équité sont documentées et testées, pas ajoutées après coup. Avec plus de 265 projets livrés dans 35 pays, l'équipe a construit des systèmes d'IA en production pour des domaines réglementés et à fort enjeu, où découvrir une disparité après le lancement n'est pas une option. Si vous cadrez une nouvelle fonctionnalité d'IA ou avez besoin d'une revue TEVV indépendante d'un système existant, commencez par un appel de cadrage de projet pour définir les exigences d'équité, le choix des métriques et les points de contrôle de gouvernance avant d'écrire la moindre ligne de code.
Auditez vos données d'entraînement à la recherche de lacunes de représentation et de valeurs manquantes non aléatoires avant d'entraîner le moindre modèle. Les correctifs au niveau des données offrent le meilleur effet de levier, car ils traitent la cause racine au lieu de la compenser en aval.
Non. Des résultats d'impossibilité mathématique montrent que les métriques d'équité courantes (calibration, égalité des taux de faux positifs, égalité des taux de faux négatifs) ne peuvent pas être satisfaites toutes en même temps lorsque les taux de base diffèrent entre groupes. L'objectif est un arbitrage documenté, surveillé et validé par les parties prenantes, pas le biais zéro.
Le cadre socio-technique et la littérature de référence sur l'équité ne définissent aucun seuil universel en pourcentage ; les exigences de représentation varient selon le cas d'usage et les populations concernées.
Plusieurs études ont constaté que les grands modèles de langage, dont ChatGPT, présentent dans leurs réponses des associations politiques et culturelles mesurables, reflet des schémas présents dans leurs données d'entraînement. Ces associations ne sont ni fixes ni uniformes selon les requêtes, et elles varient selon la version du modèle et la formulation du prompt. L'étude arXiv sur les biais des LLM classe ce phénomène parmi les biais de représentation, que l'on peut traiter par des interventions au niveau du prompt et par affinage, sans qu'aucune ne l'élimine complètement.
Une étude Nature de 2025 recommande des canaux de retour utilisateur continus comme mécanisme critique après le déploiement. Les utilisateurs qui manipulent les sorties du modèle au quotidien détectent souvent les schémas de disparité avant que les métriques agrégées ne les signalent, ce qui fait du tri structuré des retours l'un des outils de suivi les plus rentables.

 Fundamentals